把文本抽取、OCR、表格结构和页面坐标连成证据链,处理复杂文档中看似有答案却无法可靠引用的问题。
复杂文档的问题发生在检索之前
一份部署手册可能包含可复制文字、扫描截图、跨页表格和架构图。若统一提取成纯文本,表格列关系可能丢失,红色警告可能没有被识别,流程图中的分支也可能被打散。
此时增加 Top-K 很难补救。检索器找到的切片本身就缺少信息,生成模型只能围绕不完整证据组织答案。多模态 RAG 首先需要可靠的文档解析和证据表示,而不是给现有文本问答入口增加一个图片参数。
按页面内容决定解析路径
建议在文件接入后先做页面级检测,区分文字层质量、图像占比和版面类型。可选择如下路径:
| 内容类型 | 首选处理 | 重点检查 |
|---|---|---|
| 数字原生正文 | 文本与标题结构抽取 | 阅读顺序、页眉页脚 |
| 扫描页 | OCR 后恢复段落 | 数字、单位、旋转方向 |
| 表格 | 提取单元格与行列关系 | 合并单元格、跨页表头 |
| 图表与流程图 | 保存原图并生成辅助描述 | 图例、箭头、限定条件 |
Spring AI 的 ETL 文档介绍了读取、转换和写入的基本分工,以及 PDF 页读取器。不能据此假设常规 PDF 文本读取会自动完成 OCR、视觉理解或精确表格恢复;这些能力要单独选择组件和验证。
对于检测结果不确定的页面,可以保留多个解析候选,进入抽样检查或隔离队列。返回空文本不应被当作成功处理了一页。
给每块证据一个稳定位置
一个证据块至少需要文档版本、页索引、块 ID、类型、坐标与解析器版本:
{
  "documentId": "deploy-manual",
  "documentVersion": "v3",
  "pageIndex": 4,
  "blockId": "table-2-row-6",
  "kind": "table-row",
  "bbox": [0.08, 0.35, 0.92, 0.48],
  "coordinateSystem": "normalized-top-left",
  "parserVersion": "table-parser-demo-v1",
  "sourceImageId": "page-5-render"
}
这是合成数据,pageIndex 从 0 开始,因此对应读者看到的第 5 页;坐标按页面宽高归一化,以左上角为原点。裁剪、旋转或缩放页面时,需要保存坐标变换,不能直接把旧坐标画到新图上。
不同 PDF 的阅读器显示页码可能与实际文件页索引不同,可以同时保存印刷页码。点击引用时展示原始页面和对应区域,比仅显示文件名更便于核查。
表格切片要保留关系
例如原表中列为“环境、最大副本数、生效时间”,单独抽取“生产、20、2026-09”很难被可靠理解。可以生成带列名的行表示,同时保存原始单元格和表格标题。
跨页表格需要判断后一页是否延续同一表,并恢复表头;不能把第二页第一行数据误识别成新的列名。包含脚注时,脚注可能改变整张表的适用范围,应作为相关证据一起返回。
数值应保留原始字符串和解析值。例如 OCR 将“0.5”识别为“05”,必须能回到原图确认。置信度低的关键数字不宜只靠模型“猜一个合理值”。
图片描述用于召回,原图用于核实
架构图的辅助描述可以帮助文本检索发现相关页面,但它是派生信息,可能遗漏连线方向或增加图中不存在的关系。把描述当作权威事实,会让错误在检索阶段被固化。
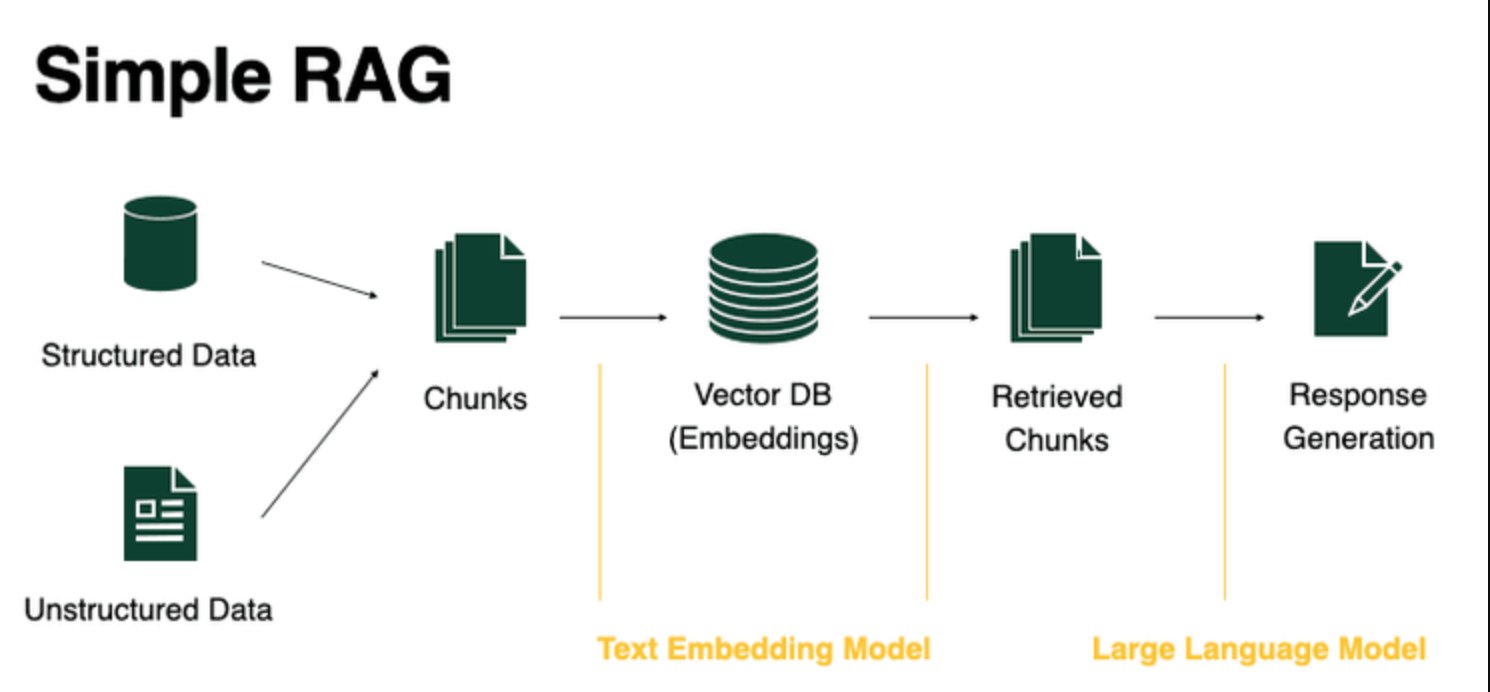
一种可实施的链路是:先用文本、表格表示和图片描述召回候选,再在需要理解图示的任务里按权限加载原图进行核实。最终回答同时关联来源块和派生描述版本。
不必每次把整本文档的页面都发给视觉模型。候选页选择、缩略图与局部裁剪能够减少输入,但裁剪不能去掉决定含义的图例和警告。具体预算由评测决定。
多模态副本继承原文权限
原图、裁剪图、OCR 文本、图片描述、向量和缓存都属于同一份资料的派生物。权限撤销与删除需要沿这些关系传播,不能只限制原始 PDF 下载。
当外部视觉模型参与解析时,在文件出站前执行数据范围和访问策略。签名图片链接不应无限期有效,也不应进入公共日志。
新的解析器版本产生了更好的正文,也不代表可以直接替换已发布证据。沿用文档入库版本设计,完成验证后发布新的证据集合,并保留引用追溯关系。
评测不要只有问答准确率
构造包含扫描页、跨页表格、旋转页、相似图例和小数点的合成资料,分别测文本抽取、结构恢复、证据召回和最终回答。回答错误时,先定位在哪一层丢失信息。
引用定位也应检查:答案中的数值是否来自高亮单元格,页码和坐标是否对应当前版本。命中了正确 PDF,但跳到无关页面,不能算完整引用成功。
最后将纯文本基线与多模态方案在相同样本上比较,同时记录解析成本、失败率和重建时间。只有明确解决了原先的文档类型问题,多模态链路新增的复杂度才有依据。